
Large Language Model (LLM) kini menjadi fondasi berbagai aplikasi berbasis kecerdasan buatan, mulai dari chatbot, AI assistant, hingga sistem pencarian berbasis generative AI. Namun, membangun aplikasi dengan LLM bukan hanya soal memilih model yang paling canggih. Tantangan sebenarnya adalah memastikan bahwa jawaban yang dihasilkan selalu relevan, akurat, konsisten, dan sesuai dengan kebutuhan pengguna.
Disinilah evaluasi LLM menjadi bagian yang tidak bisa diabaikan. Tanpa proses evaluasi yang baik, sulit mengetahui apakah performa model benar-benar meningkat setelah dilakukan prompt engineering, fine-tuning, atau integrasi dengan Retrieval-Augmented Generation (RAG). Artikel ini membahas bagaimana cara mengukur kualitas jawaban AI secara lebih objektif serta metrik yang umum digunakan dalam evaluasi LLM.
Mengapa Evaluasi LLM Sangat Penting?
Model bahasa modern mampu menghasilkan respons yang terdengar meyakinkan, tetapi belum tentu benar. Bahkan model dengan parameter yang besar masih dapat mengalami hallucination, menghasilkan informasi usang, atau memberikan jawaban yang tidak sesuai konteks.
Evaluasi membantu tim pengembang memahami kualitas model berdasarkan data, bukan sekedar kesan saat melakukan uji coba. Dengan demikian, keputusan seperti mengganti model, memperbarui prompt, atau melakukan fine-tuning dapat dilakukan berdasarkan hasil pengukuran yang jelas.
Bagi perusahaan, evaluasi juga berperan dalam menjaga kualitas layanan AI. Ketika chatbot digunakan untuk customer service atau sistem internal, kualitas jawaban secara langsung mempengaruhi pengalaman pengguna dan tingkat kepercayaan terhadap sistem.
Aspek yang Dinilai dalam Evaluasi LLM
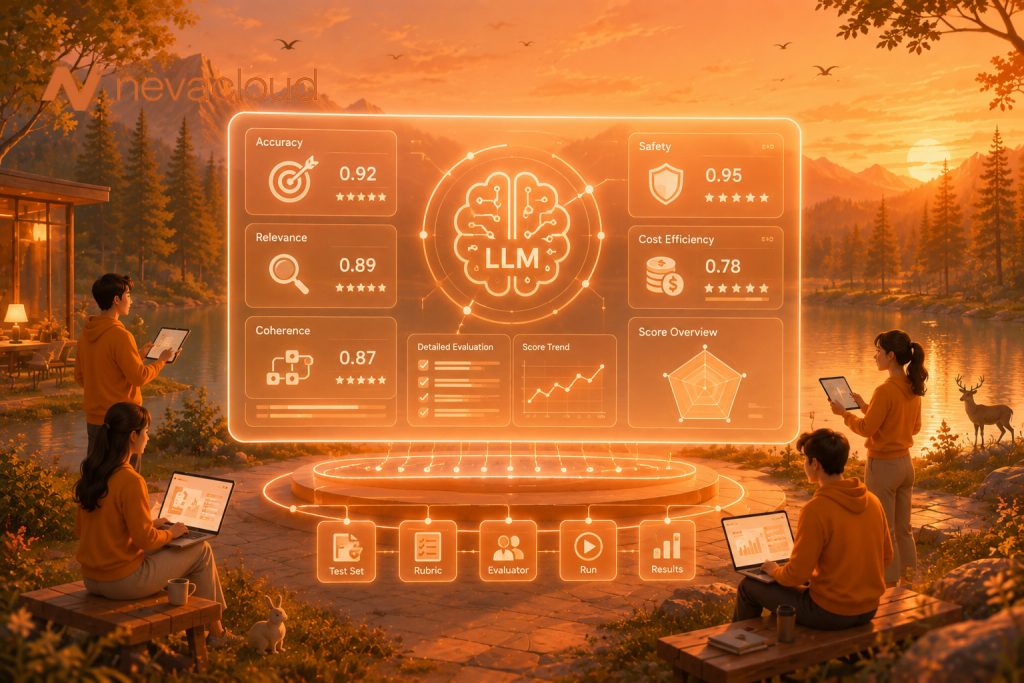
Menilai kualitas LLM tidak cukup hanya melihat apakah jawabannya benar atau salah. Ada beberapa aspek yang perlu diperhatikan agar evaluasi lebih komprehensif.
Akurasi Informasi
Akurasi menjadi indikator utama dalam menilai kualitas jawaban AI. Model harus mampu memberikan informasi yang benar, dapat diverifikasi, dan tidak mengarang fakta. Hal ini sangat penting untuk aplikasi di bidang kesehatan, hukum, keuangan maupun layanan pelanggan yang membutuhkan tingkat kepercayaan tinggi.
Relevansi terhadap Pertanyaan
Jawaban yang benar belum tentu relevan. Model harus memahami maksud pengguna dan memberikan respons yang benar-benar menjawab pertanyaan. Misalnya, ketika pengguna meminta langkah konfigurasi server Linux, model tidak seharusnya memberikan penjelasan umum mengenai sistem operasi Linux tanpa membahas konfigurasi yang dimaksud.
Konsistensi Jawaban
LLM bersifat probabilistik sehingga jawaban dapat berbeda untuk pertanyaan yang sama. Evaluasi perlu memastikan bahwa model menghasilkan respons yang relatif konsisten, terutama untuk pertanyaan yang memiliki jawaban pasti. Konsistensi menjadi faktor penting pada aplikasi enterprise yang membutuhkan standar layanan yang seragam.
Metode Evaluasi LLM yang Umum Digunakan
Berbagai metode dapat digunakan untuk mengukur performa model sesuai kebutuhan aplikasi.
Human Evaluation
Metode ini melibatkan evaluator yang menilai kualitas jawaban berdasarkan beberapa kriteria, seperti akurasi, relevansi, kelengkapan, hingga gaya bahasa. Human evaluation masih dianggap sebagai standar terbaik karena manusia mampu memahami konteks yang sulit diukur oleh mesin. Namun, metode ini membutuhkan waktu, biaya, dan konsistensi penilaian antar evaluator.
Automatic Evaluation
Automatic evaluation menggunakan metrik tertentu untuk membandingkan jawaban model dengan referensi yang telah disiapkan. Pendekatan ini jauh lebih cepat sehingga cocok digunakan dalam proses pengujian yang dilakukan secara berkala selama pengembangan aplikasi AI. Meski demikian, hasilnya tetap perlu dikombinasikan dengan evaluasi manual karena tidak semua kualitas jawaban dapat direpresentasikan oleh angka.
LLM-as-a-Judge
Pendekatan yang semakin populer adalah menggunakan LLM lain sebagai evaluator. Model evaluator akan membandingkan jawaban berdasarkan rubrik tertentu, misalnya ketepatan, relevansi, atau kelengkapan. Cara ini mampu mempercepat proses evaluasi dalam skala besar sekaligus mengurangi beban penilaian manual.
Namun, hasil evaluasi tetap perlu divalidasi secara berkala agar tidak terjadi bias dari model evaluator.
Metrik yang Sering Digunakan dalam Evaluasi LLM
Berbagai metrik tersedia untuk menilai performa model, tergantung jenis tugas yang dilakukan.
BLEU dan ROUGE
BLEU banyak digunakan pada tugas penerjemahan mesin, sedangkan ROUGE lebih umum dipakai untuk evaluasi ringkasan otomatis. Keduanya mengukur tingkat kemiripan antara jawaban model dengan jawaban referensi berdasarkan kesamaan kata atau frasa. Meskipun masih sering digunakan, kedua metrik ini memiliki keterbatasan karena tidak benar-benar memahami makna sebuah kalimat.
BERTScore
BERTScore memanfaatkan embedding dari model bahasa untuk membandingkan makna semantik antara jawaban model dan referensi. Pendekatan ini mampu memberikan hasil yang lebih baik dibandingkan sekedar mencocokkan kata demi kata, sehingga lebih sesuai untuk mengevaluasi teks yang memiliki variasi penyampaian.
Exact Match dan F1 Score
Pada aplikasi Questioning Answering, Exact Match digunakan untuk mengukur apakah jawaban model identik dengan jawaban referensi. Sementara itu, F1 Score menghitung keseimbangan antara precision dan recall sehingga lebih fleksibel ketika jawaban memiliki sedikit perbedaan kata tetapi tetap mengandung informasi yang benar.
Tantangan dalam Mengukur Kualitas Jawaban AI
Evaluasi LLM bukanlah proses yang sederhana. Ada beberapa tantangan yang sering dihadapi selama proses pengujian. Pertama, tidak semua pertanyaan memiliki satu jawaban yang benar. Sebuah pertanyaan terbuka dapat memiliki berbagai respons yang sama-sama valid sehingga sulit dievaluasi menggunakan metrik tradisional.
Kedua, kualitas jawaban seringkali dipengaruhi oleh prompt yang digunakan. Perubahan kecil pada instruksi dapat menghasilkan respons yang berbeda, sehingga proses evaluasi harus menggunakan skenario pengujian yang konsisten.
Ketiga, dataset evaluasi harus benar-benar representatif terhadap kondisi nyata. Jika seluruh pengujian hanya menggunakan pertanyaan sederhana, hasil evaluasi tidak akan menggambarkan performa model saat menghadapi kasus yang lebih kompleks.
Terakhir, aplikasi berbasis RAG juga perlu mengevaluasi kualitas dokumen yang diambil sebelum menilai jawaban akhir. Jawaban AI yang kurang tepat belum tentu disebabkan oleh model, tetapi bisa berasal dari proses retrieval yang tidak optimal.
Best Practice Evaluasi LLM untuk Lingkungan Produksi
Agar hasil evaluasi benar-benar bermanfaat, perusahaan sebaiknya menerapkan proses evaluasi secara berkelanjutan, bukan hanya saat awal pengembangan. Gunakan kombinasi evaluasi otomatis dan evaluasi manual untuk memperoleh gambaran yang lebih lengkap mengenai performa model. Automatic evaluation dapat digunakan untuk regression testing, sedangkan human evaluation membantu menilai kualitas yang berkaitan dengan konteks dan pengalaman pengguna.
Selain itu, bangun benchmark internal yang berisi pertanyaan-pertanyaan sesuai kebutuhan bisnis. Dengan cara ini, setiap pembaruan model dapat dibandingkan menggunakan standar yang sama sehingga perubahan performa lebih mudah dipantau.
Monitoring setelah sistem digunakan juga tidak kalah penting. Umpan balik pengguna, tingkat keberhasilan penyelesaian tugas, hingga kasus hallucination yang ditemukan di lingkungan produksi dapat menjadi sumber data berharga untuk meningkatkan kualitas AI secara berkelanjutan.
Bangun Solusi AI yang Andal dengan Infrastruktur Cloud yang Tepat
Evaluasi LLM merupakan langkah penting untuk memastikan sistem AI menghasilkan jawaban yang akurat, relevan, dan konsisten. Dengan menggabungkan berbagai metode evaluasi serta metrik yang sesuai, perusahaan dapat mengambil keputusan berbasis data dalam mengembangkan aplikasi AI yang lebih andal.
Namun, proses evaluasi maupun deployment LLM membutuhkan infrastruktur komputasi yang stabil, skalabel, dan mampu menangani beban kerja AI yang terus berkembang. Nevacloud menyediakan layanan cloud infrastructure yang mendukung kebutuhan pengembangan aplikasi modern, mulai dari penyediaan server berkinerja tinggi hingga lingkungan yang fleksibel untuk menjalankan workload AI, machine learning, dan berbagai aplikasi enterprise. Dengan infrastruktur yang tepat, proses pengembangan dan evaluasi AI dapat berjalan lebih optimal sekaligus siap mendukung pertumbuhan bisnis.


 Titis Nur Pratomo

 Hiqbal Fauzi